Excel標準偏差の罠!Stdev. PとSの違い・正しい求め方
 著者: 橋本 菜々子
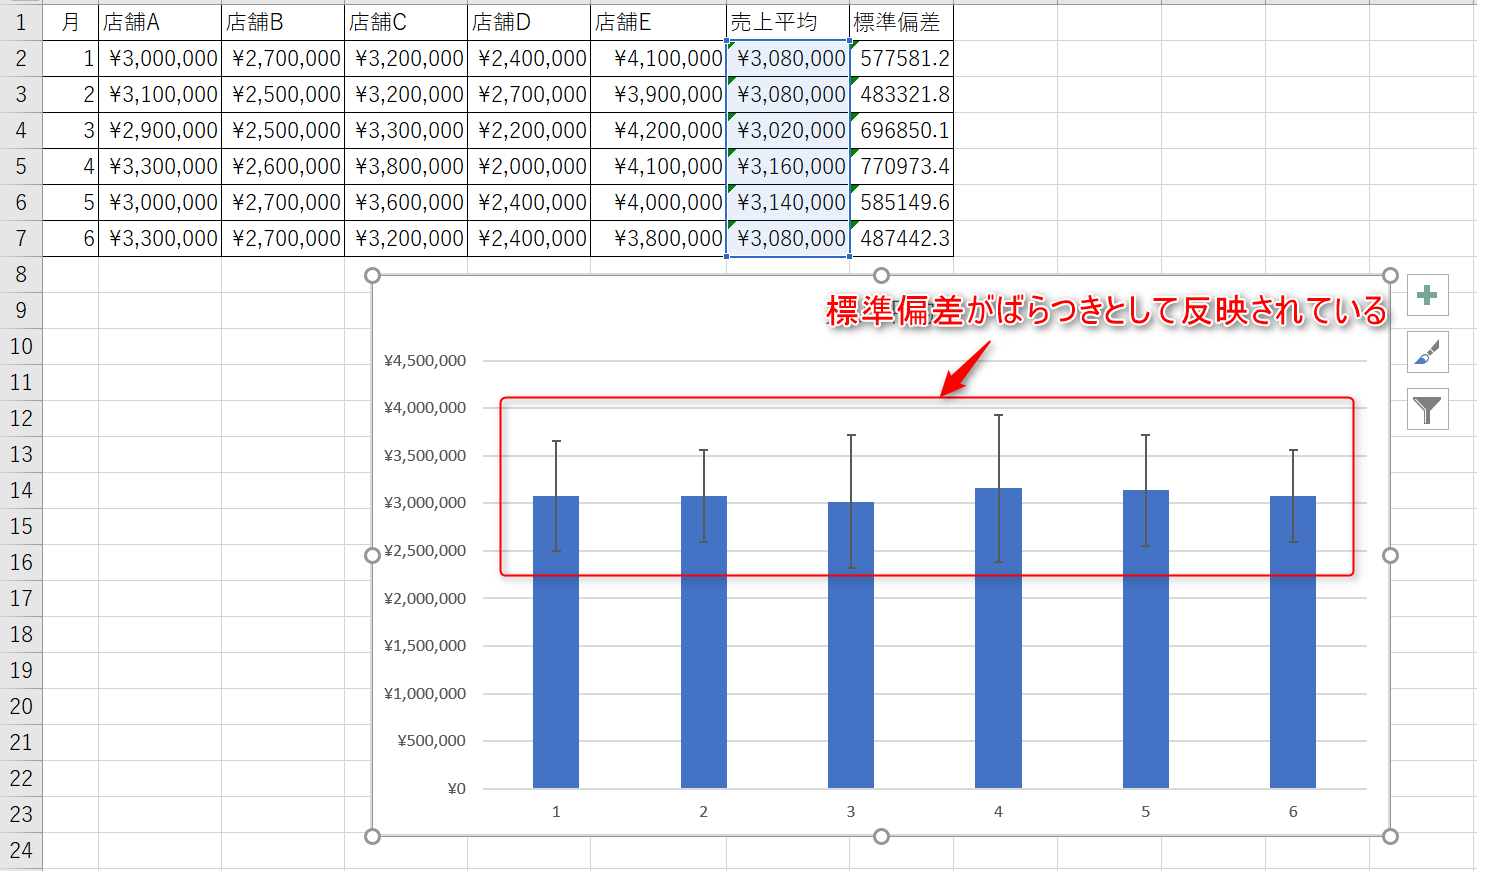
ネット上の簡易解説記事やSNS上の言説には、一部ミスリーディングな情報が散見されます。特に注意すべき2つの盲点を検証します。
第一の誤解は、「サンプルサイズが30以上あればSTDEV.PでもSTDEV.Sでもどちらでもよい」という言説です。中心極限定理の文脈と混同されがちですが、標本から母集団を推測している以上、統計学的な厳密さにおいて $N-1$ を分母とするSTDEV.Sを使うのが論理的正解です。ツール任せで関数の違いを曖昧にする姿勢は、監査や厳密なデータ検証の場で致命的な指摘を受けるリスクを孕んでいます。
第二の盲点は、「外れ値(極端値)が存在するデータでの標準偏差の過信」です。標準偏差はすべてのデータを二乗して計算するため、入力ミスや異常値によって1点だけ極端な数値が含まれていると、ばらつきの値が跳ね上がってしまいます。データ集計の現場では、標準偏差を機械的に算出する前に、箱ひげ図などで外れ値を検出し、除外処理を行うか「四分位範囲(IQR)」などの頑健な指標を併用する配慮が不可欠です。
【プロの結論】向いているケース・使い分けの判断基準
組織全体でデータリテラシーを高め、集計ミスをゼロにするための意思決定フローを以下に提示します。
【STDEV.Pを選ぶべきケース】
・自社の全従業員(100%)を対象とした人事評価・給与分析
・工場ラインにおける全数検査(全ロット測定)データ
・過去に終了した特定のプロジェクト全件の確定実績集計
【STDEV.Sを選ぶべきケース】
・一部のユーザーを抽出したアンケート調査やABテストのログ
・抜き取り検査による製品ロットの品質検証
・将来の傾向や全体像を予測するためのサンプルデータ分析
判断に迷った場合は、「測定していない対象がまだ世の中に存在するかどうか」を自問してください。残りのデータが存在するならば、迷わず「STDEV.S」を選択するのが鉄則です。
グルメと旅を愛するフリーライター。全国各地の隠れた魅力を独自の視点から紹介します。
